联想凌拓陈弘:存储闪跃AI就绪——从数据容器到智算引擎
AI正在重构存储产业的价值定位。
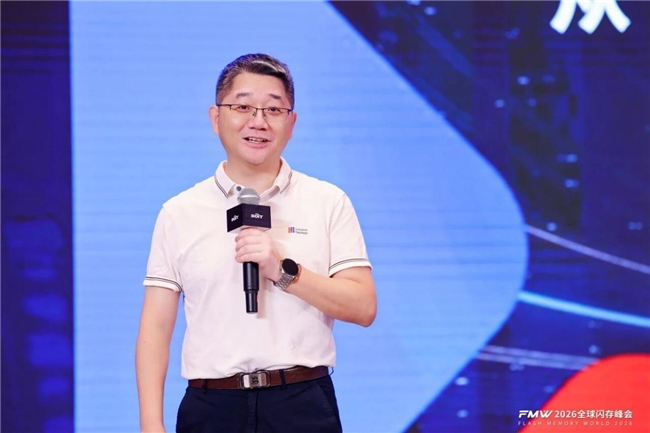
(联想凌拓首席技术官 陈弘)
8月26日,2026全球闪存峰会上,联想凌拓首席技术官陈弘发表《存储闪跃 AI就绪——从数据容器到智算引擎》主题演讲。面对生成式AI规模化落地带来的全新产业挑战,他提出:传统存储只是被动承载业务的数据容器,而AI时代,存储正在靠近计算、贴近业务,升级为释放数据价值的“智算引擎”。
与这一变化相对应,联想凌拓也完成了角色转变——从存储厂商进一步转型成为AI数据基础设施产品、方案和服务提供商。
这也是此次演讲所强调的——存储闪跃 AI就绪,存储技术的突破,企业数字化转型,皆因AI而起。
AI时代,存储要让数据跟着算力走
进入AI时代,数据“存好”是不够的,企业更需要思考:如何让数据跟随业务节奏,及时供给算力,真正释放AI业务价值。
在AI基础设施中,数据不会长期固定在某一个智算集群里。根据业务、电力、算力和资源需求变化,数据需要在不同层级和不同集群之间流动。例如,当智算集群启动时,数据需要快速调入。而在任务进入休眠阶段后,又需要将数据迁移到成本更优的长期存储层级。
因此,面向AI场景,存储除了要继续关注性能和成本,还要在底层实现数据智能分层、流转以及完整生命周期管理。
围绕这一变化,联想凌拓构建起更加完整AI数据基础设施产品矩阵,包括NetApp AFX解耦式全闪存、面向HPC和AI场景的Lustre存储、混合多云的数据加速器FlexCache等。本次峰会上,联想凌拓全新DXN5000 G5全闪分布式存储,还斩获峰会“2026年度KV Cache闪存奖”。
NetApp AFX解耦式全闪存,新增第三个智算平面
NetApp AFX解耦式全闪存采用控制节点和数据节点的解耦全闪存架构。传统存储架构中,控制和数据通常紧密关联,而NetApp AFX将控制节点与后端数据节点分离,使存储性能和容量可以分别扩展。
值得关注的是,联想凌拓在此基础上还增加了第三个平面——数据智算平面。由此形成三个平面——控制平面负责协议和存储访问;数据平面负责可扩展的数据存储;数据智算平面则进一步把靠近计算和业务的数据预处理、工作流以及AI智能体能力纳入存储体系。
针对AI业务场景,NetApp AFX完成两项关键专项强化:
第一,是高性能pNFS over RDMA,相比拥有极致性能但对业务有影响的Process客户端,其适配计算节点的协议访问模式,实现大幅性能提升。
第二,是强化多租户能力,面向智算、算力云的多租户共享集群场景,在实现租户数据安全隔离的基础上,提供可保障的QoS能力。EDA芯片设计场景就是该架构能力的典型落地场景。
EDA场景:为什么芯片设计越来越考验存储?
EDA是一整套芯片设计工业软件工具链。在陈弘看来,芯片设计行业,集中体现了AI给存储带来的全新需求。
依托NetApp在芯片设计领域近三十年ONTAP技术积累,随着AI、智能体进一步进入芯片设计、仿真和测试流程,原有EDA工具链也出现了新的变化。EDA工具链的协同模式正在发生深刻改变,存储的命题已经不再只是“提供更高 IO 性能”,而是如何实现智能体就绪。
联想凌拓在与头部芯片企业的实践交流中发现,智能体时代的存储需求主要集中在两个方面:
一是存储要能够更直接与AI智能体交互,让数据能力进入智能体工作流;
二是解决跨部门、跨团队的数据隔离和访问控制问题。芯片企业内部存在多个研发部门和项目组,不同团队的数据敏感等级、可靠性及安全要求并不相同,因此智能体就绪还意味着必须建立清晰的数据边界和安全边界。
除了AI智能体带来的交互和治理挑战,EDA本身也是典型的数据密集型负载。大规模芯片设计和仿真涉及大量小文件和小I/O访问,对随机访问、元数据处理和并发能力提出较高要求。
FlexCache:当算力可以跨云调用,数据不用整体搬家
芯片设计和仿真通常有明显的项目周期特征。
企业日常研发主要依赖本地数据中心,进入仿真验证阶段,算力需求会短时间内迅速增加。本地资源不足,企业就可能临时调用云端或其他数据中心的计算资源。
这时,算力可以临时获得,数据却未必适合整体迁移。FlexCache正是联想凌拓面向该场景打造的混合多云数据加速器。
FlexCache可以在远端数据中心或者靠近计算的位置部署一个具备完整文件访问能力的缓存层,而真正持久化的数据仍然保留在源端ONTAP系统中。当企业临时调用异地或者云端算力时,无需整体迁移整套研发数据集,远端集群即可按需访问所需数据。
目前,这种能力已经可以覆盖谷歌云、AWS、Azure以及火山引擎等主流公有云环境。
对于芯片设计企业而言,这意味着一种更加灵活的算力使用方式——平时数据可以保留在企业本地,当大型项目突然需要额外算力时,再临时调用外部计算资源,而不必提前进行一次大规模的数据搬迁。
在技术上,FlexCache具有四个关键特点:采用原生架构,远端缓存与源端保持一致的文件访问能力;支持切片、块级小I/O缓存;持续同步元数据,缓解海量小文件场景访问瓶颈;同时兼容读、读写混合的复杂业务负载。这些能力高度匹配EDA行业海量小文件、高频读写、跨地域算力调度的业务特征。FlexCache定位就是连接本地数据与远端算力的数据加速层。
从高性能数据供给到Data Agent,进一步完善AI数据基础设施
除NetApp AFX和FlexCache之外,联想凌拓也在继续补强HPC与AI场景下的高性能文件存储能力。今年,NetApp面向Lustre场景推出NetApp EF系列产品。在国内市场,升级后的MagnaScale Ultra面向训练、推理等高性能场景,单节点吞吐超过150GB/s,单文件系统支持5000亿+文件,同时持续适配国产处理器、存储介质及硬件平台。
此外,随着智能体快速发展,软件和数据管理的交互方式本身也在发生变化。围绕这一方向,联想凌拓通过联想存储智能体和智算平台提供Data Agent能力。基于ONTAP已有API和Toolkit,相关能力被进一步封装为MCP Server和Skill,用户可以通过自然语言查询存储运行状态,执行部分生命周期管理和配置操作。结合MCP和Skill,售前工程师还可以借助AI Coding工具快速构建基于ONTAP数据的企业知识库RAG。
整体而言,AI迅猛发展之下,存储的价值边界正在被重新改写。不只追求简单的数据存放,更要打通数据、算力与智能应用的全链路,帮助企业化解AI落地过程中的数据流转、治理与安全挑战。立足这一行业变革,联想凌拓正以AI数据基础设施产品、方案和服务,助力更多企业真正实现 “存储闪跃AI就绪”,加速AI业务从试点走向规模化生产落地。
